Dell Poweredge6850服务器安装windows2008操作系统的办法

现有一台Dell poweredge6850服务器,需要安装windows2008 64位操作系统,做好raid后,直接使用windows2008安装盘安装,需要加载阵列卡驱动,驱动下载地址:http://downloads.dell.com/scsi-raid/LSI-LOGIC_MULTI-DEVICE_A00_R227150.exe,该驱动包含了LSI Logic PERC 4e/DC, Perc 4e/Di, PERC 4e/Si这三种阵列卡在windows2008操作系统下的驱动。

加载好阵列卡驱动后,即可继续安装,安进入系统可以看到其他所有驱动也都已安装好。

常用dmidecode命令

Dmicode这款软件可以在linux操作系统中收集硬件信息,该软件遵循SMBIOS标准,其输出的信息包括系统制造商、型号、序列号、BIOS版本、CPU、内存、PCI、及I/O接口等,该软件非常强大也非常实用。

SMBIOS(System Management BIOS)和DMI(Desktop Management Interface)都是由DMTF(Desktop Management Task Force)起草的开放性的技术标准,DMTF组织于1992年成立,DMTF工作组致力于分布式IT系统的有效管理,通过聚合众多IT厂商一起来进行管理系统的开发、效用及改进等标准化工作。其官方网站为:http://www.dmtf.org/

以下为常用的dmidecode命令:
1、精简显示dmi信息
#dmidecode -q
2、查看设备的型号
dmidecode | grep ‘Product Name’
3、查看设备的序列号
dmidecode |grep ‘Serial Number’
4、查看系统的序列号
dmidecode -s system-serial-number
5、查看内存槽位及内存大小
dmidecode|grep P A5 “Memory\s+Device”|grep Size|grep v Range
6、查看支持的最大内存数
dmidecode|grep P ‘Maximum\s+Capacity’

dmidecode参数string关键字如下:
bios-vendor
bios-version
bios-release-date
system-manufacturer
system-product-name
system-version
system-serial-number
system-uuid
baseboard-manufacturer
baseboard-product-name
baseboard-version
baseboard-serial-number
baseboard-asset-tag
chassis-manufacturer
chassis-type
chassis-version
chassis-serial-number
chassis-asset-tag
processor-family
processor-manufacturer
processor-version
processor-frequency

dmidecode参数type关键字如下:
bios
system
baseboard
chassis
processor
memory
Cache
connector
slot

type全部编码列表:
0 BIOS
1 System
2 Base Board
3 Chassis
4 Processor
5 Memory Controller
6 Memory Module
7 Cache
8 Port Connector
9 System Slots
10 On Board Devices
11 OEM Strings
12 System Configuration Options
13 BIOS Language
14 Group Associations
15 System Event Log
16 Physical Memory Array
17 Memory Device
18 32-bit Memory Error
19 Memory Array Mapped Address
20 Memory Device Mapped Address
21 Built-in Pointing Device
22 Portable Battery
23 System Reset
24 Hardware Security
25 System Power Controls
26 Voltage Probe
27 Cooling Device
28 Temperature Probe
29 Electrical Current Probe
30 Out-of-band Remote Access
31 Boot Integrity Services
32 System Boot
33 64-bit Memory Error
34 Management Device
35 Management Device Component
36 Management Device Threshold Data
37 Memory Channel
38 IPMI Device
39 Power Supply
40 Additional Information
41 Onboard Device

更多关于dmidecode的信息,参见http://www.nongnu.org/dmidecode/
更多关于SMBIOS的信息,参见http://www.dmtf.org/cn/standards/smbios

重置IBM刀片服务器的管理模块

IBM刀片服务器管理模块有一个重置按钮,可以通过使用重置按钮来重置管理模块将其恢复到出厂设置。

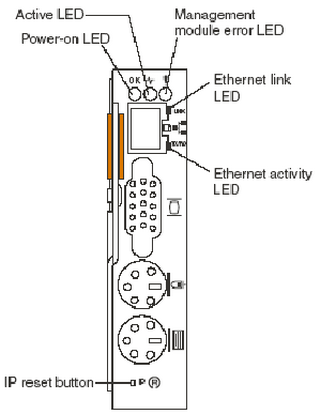
IBM刀片管理模块重置按钮如下:
IBM重置管理口
可通过环形针来使用这个重置按钮。

这个重置按钮主要有两个作用:
1、重置管理口的网络配置,操作方法为按住重置按钮3秒(或3秒以内)
2、重置整个管理模块,包括网络配置及用户名、密码,操作方法为按住重置按钮5秒,释放重置按钮并等5秒,按住重置按钮10秒。

重置网络配置后,默认管理模块是采用DHCP,主机名是MMxxxx,xxxx是管理口的MAC地址,这个MAC地址印在重置按钮下方。如果没有DHCP服务器,那么管理口默认使用192.168.70.125,子网掩码为255.255.255.0,主机名也是MMxxxx。

重置用户名和密码后,用户名和密码都会恢复出厂设置,用户名为USERID,都是大写字母,密码为PASSW0RD,倒数第三位是数字0,其余为大写字母。


tp-link无线路由器WDS无线桥接功能设置说明

在面积较大的家庭或办公环境(如别墅、写字间等),路由器无线覆盖范围有限,部分区域信号较弱到或存在信号盲点。无线桥接(WDS)功能可以将无线网络通过无线进行扩展,只需简单设置即可实现无线扩展、漫游的需求。

目前大部分tp-link无线路由器都有WDS功能,Wireless Distribution System即无线分布式系统,WDS的功能是充当无线网络的中继器,通过在无线路由器上开启WDS功能,让其可以延伸扩展无线信号,从而覆盖更广更大的范围。说白了WDS就是可以让无线AP或者无线路由器之间通过无线进行桥接(中继),而在中继的过程中并不影响其无线设备覆盖效果的功能。这样我们就可以用两个无线设备,让其之间建立WDS信任和通讯关系,从而将无线网络覆盖范围扩展到原来的一倍以上,大大方便了我们无线上网。

应用场景:
主、副路由器通过无线WDS桥接,无线终端可以连接主、副路由器上网,移动过程中可以自动切换,实现漫游。

设置步骤:
第一步,设置主路由器无线参数
参数如下:
SSID:zhangsan
无线密码:1a2b3c4d
无线信道:6
无线桥接(WDS)的主要操作均在副路由器完成,只需固定主路由器的无线信道。

第二步,设置副路由器
1、修改管理IP地址
修改副无线路由器的LAN口IP地址,如主路由器的IP地址是192.168.1.1,则副路由器修改为192.168.1.2。
2、修改无线设置及开启WDS扫描
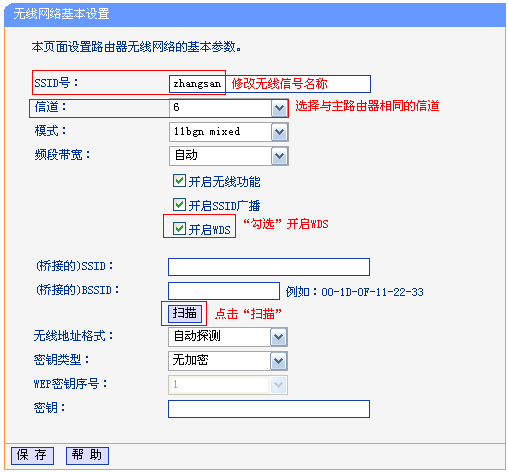
使用修改后的IP地址登录路由器管理界面,点击无线设置 >> 无线基本设置,设置与主路由器相同的 SSID号 及 信道,勾选 开启WDS,点击 扫描。

3、选择主路由器信号
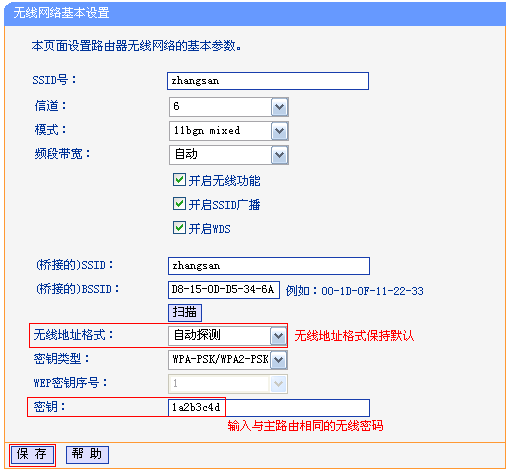
在扫描页面中找到主路由器的无线SSID,并点击连接。
4、输入密码
在密钥位置输入主路由器的无线密码,输入完成后点击保存。

5、设置副路由器的无线密码
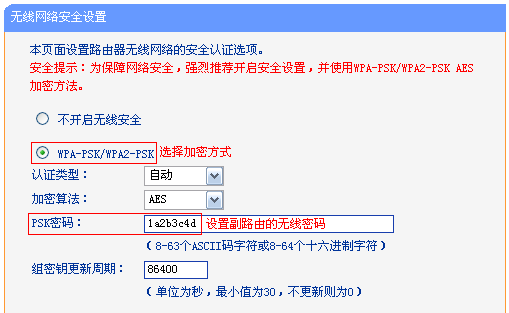
点击无线设置 >> 无线安全设置,选择与主路由器相同的加密方式,在 PSK密码 中设置与主路由器相同的无线密码,点击保存。

这里,副路由器的SSID、无线密码可与主路由器不同,但如果需要实现漫游,则必须与主路由器相同。
6、关闭副路由器的DHCP服务器并重启副路由器

第三步、确认桥接成功
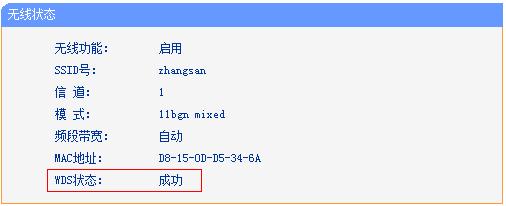
在副路由器重启完成后,在路由器的管理界面,点击运行状态,观察无线状态 >> WDS状态,显示成功则表示桥接WDS设置成功。

至此无线桥接(WDS)设置完成,无线终端连接zhangsan,有线电脑连接主、副路由器的LAN口即可上网。终端移动过程中,可以实现主、副路由器间的自动漫游。

CPU节能模式导致linux操作系统宕机的解决办法

有台HP DL380 G6服务器,安装有redhat linux as5.6 64位操作系统,安装好操作系统后,服务器有时出现宕机现象,每次重启后都恢复正常,经查看日志发现有CPU frequency相关的信息,根据该信息可以看出CPU不支持频率调整,需要设置“CPUFREQ_ENABLED=no”和“SUSPEND2RAM_FORCE=yes”的参数。

经过分析可以看出宕机现象是由服务器上CPU的节能模式引起,解决的办法就是在BIOS中关闭CPU的节能模式,或者修改cpufreq的配置参数:
#vi /etc/powersave/cpufreq
CPUFREQ_ENABLED=”no”
重启/etc/init.d/powersave即可。

cpufreq技术:

在cpufreq中内置了5种策略:performance、powersave、userspace、ondemand、conservation。默认采用ondemand策略,在该策略里每80个毫秒就采集一次cpu的使用率,同时假设前后两次cpu使用率是相同的。通过前一次的cpu使用率推出后一个cpu使用率,完了进行频率设置。所以就总的思想来说还不是很难理解。

变频技术是指CPU硬件本身支持在不同的频率下运行,系统在运行过程中可以根据随时可能发生变化的系统负载情况动态在这些不同的运行频率之间进行切换,从而达到对性能和功耗做到二者兼顾的目的。

虽然多个处理器生产厂家都提供了对变频技术的支持,但是其硬件实现和使用方法必然存在着细微甚至巨大的差别。这就使得每个处理器生产厂家都需要按照其特殊的硬件实现和使用方法向内核中添加代码,从而让自己产品中的变频技术在 Linux 中得到支持和使用。然而,这种内核开发模式所导致的后果是各个厂家的实现代码散落在 Linux 内核代码树的各个角落里,各种不同的实现之间没有任何代码是共享的,这给内核的维护以及将来添加对新的产品的支持都带来了巨大的开销,并直接导致了cpufreq 内核子系统的诞生。

管理策略:

Linux内部共有五种对频率的管理策略userspace,conservative,ondemand,powersave和 performance

1.performance :CPU会固定工作在其支持的最高运行频率上;

2.powersave :CPU会固定工作在其支持的最低运行频率上。因此这两种governors 都属于静态 governor ,即在使用它们时 CPU 的运行频率不会根据系统运行时负载的变化动态作出调整。这两种 governors 对应的是两种极端的应用场景,使用performance governor 体现的是对系统高性能的最大追求,而使用 powersave governor则是对系统低功耗的最大追求。

3.Userspace:最早的 cpufreq 子系统通过 userspace governor 为用户提供了这种灵活性。系统将变频策略的决策权交给了用户态应用程序,并提供了相应的接口供用户态应用程序调节 CPU 运行频率使用。 (可以使用Dominik 等人开发了 cpufrequtils工具包 )

4.ondemand :userspace是内核态的检测,效率低。而ondemand正是人们长期以来希望看到的一个完全在内核态下工作并且能够以更加细粒度的时间间隔对系统负载情况进行采样分析的 governor。当CPU有负载的时候选用最大的主频,当CPU空闲的时候一步步降低.

5.conservative : ondemand governor 的最初实现是在可选的频率范围内调低至下一个可用频率。即根据CPU使用情况进行升或降频,这种降频策略的主导思想是尽量减小对系统性能的负面影响,从而不会使得系统性能在短时间内迅速降低以影响用户体验。

但是在 ondemand governor 的这种最初实现版本在社区发布后,大量用户的使用结果表明这种担心实际上是多余的, ondemand governor 在降频时对于目标频率的选择完全可以更加激进。因此最新的 ondemand governor 在降频时会在所有可选频率中一次性选择出可以保证 CPU 工作在 80% 以上负荷的频率,当然如果没有任何一个可选频率满足要求的话则会选择 CPU 支持的最低运行频率。大量用户的测试结果表明这种新的算法可以在不影响系统性能的前提下做到更高效的节能。在算法改进后, ondemand governor 的名字并没有改变,而 ondemand governor 最初的实现也保存了下来,并且由于其算法的保守性而得名 conservative 。

Ondemand降频更加激进,conservative降频比较缓慢保守,事实使用ondemand的效果也是比较好的。和ondemand管理器不同的是,在CPU负载高的时候conservative 并不直接跳上最高的主频,而是采用步进的方式来升高主频。

解决浏览器缓存导致不能显示最新页面问题的办法

由于浏览器缓存机制的原因,使得浏览器在访问过页面后,对该页面产生缓存,当再次访问该页面,一般浏览器会直接从缓存读取,而不显示页面的最新内容,对于这种问题,我们可以在浏览器的选项中设置,如设置IE的IE选项,常规——浏览历史记录——设置————Internet临时文件,检查存储的页面的较新版本,默认是“自动“,将”自动”改为“每次访问网页时”,即可解决该问题。

这四个选项的作用和意义如下:

每次访问网页时”选项表示浏览器每次访问一个页面时,不管浏览器是否缓存过此页面,都要向服务器发出访问请求。这种设置的优点是实时性很强,肯定能够访问到网页的最新内容,但是如果网页内容很少更新,这种设置的访问效率就比较低了。

每次启动Internet Explorer时”选项表示在浏览器的每次启动运行期间,在第一次访问一个页面时,不管浏览器是否缓存过此页面,都要向服务器发出访问请求,但是在浏览器的本次启动运行期间对该页面的后续访问,浏览器将不再向服务器发出访问请求,而是直接使用缓存中的内容。这种设置具有较高的访问效率,同时也兼顾了较好的实时性,它可以保证每次启动浏览器后看到的都是最新的网页内容。

自动”选项与“每次启动Internet Explorer时检查”选项的功能相似,只是对图像的访问有所不同,如果随着时间的推移,浏览器发现网页上的图像更新并不频繁,这样,即使浏览器在对某个已缓存的图像执行本次启动运行以来的第一次访问时,它也不一定会向服务器发出访问请求,而是干脆直接使用缓存中的内容。“自动”选项是浏览器的默认设置,所以,几乎所有人的浏览器都是按照这种方式工作的,这个选项的作用和意义应该成为读者熟悉的重点。

从不”选项表示浏览器不管在什么情况下访问一个页面时,只要能够在本地找到此页面的缓存信息,浏览器就不会向服务器发出访问请求,而是直接使用缓存的内容。这种设置的优点是访问效率很高,但是如果服务器端的网页内容更新后,浏览器看到的内容很可能是过期的内容。

附:浏览器缓存机制介绍,详见http://www.eumz.com/2015-09/1227.html

浏览器缓存机制介绍

浏览器缓存机制,其实主要就是HTTP协议定义的缓存机制(如: Expires; Cache-control等)。但是也有非HTTP协议定义的缓存机制,如使用HTML Meta 标签,Web开发者可以在HTML页面的<head>节点中加入<meta>标签,代码为:<META HTTP-EQUIV=”Pragma” CONTENT=”no-cache”>,该代码的作用是告诉浏览器当前页面不被缓存,每次访问都需要去服务器拉取。使用上很简单,但只有部分浏览器可以支持,而且所有缓存代理服务器都不支持,因为代理不解析HTML内容本身。

Expires是Web服务器响应消息头字段,在响应http请求时告诉浏览器在过期时间前浏览器可以直接从浏览器缓存取数据,而无需再次请求。不过Expires 是HTTP 1.0的东西,现在默认浏览器均默认使用HTTP 1.1,所以它的作用基本忽略。

Cache-Control与Expires的作用一致,都是指明当前资源的有效期,控制浏览器是否直接从浏览器缓存取数据还是重新发请求到服务器取数据。只不过Cache-Control的选择更多,设置更细致,如果同时设置的话,其优先级高于Expires。

http协议头Cache-Control
值可以是public、private、no-cache、no- store、no-transform、must-revalidate、proxy-revalidate、max-age
各个消息中的指令含义如下:
Public指示响应可被任何缓存区缓存。
Private指示对于单个用户的整个或部分响应消息,不能被共享缓存处理。这允许服务器仅仅描述当用户的部分响应消息,此响应消息对于其他用户的请求无效。
no-cache指示请求或响应消息不能缓存
no-store用于防止重要的信息被无意的发布。在请求消息中发送将使得请求和响应消息都不使用缓存。
max-age指示客户机可以接收生存期不大于指定时间(以秒为单位)的响应。
min-fresh指示客户机可以接收响应时间小于当前时间加上指定时间的响应。
max-stale指示客户机可以接收超出超时期间的响应消息。如果指定max-stale消息的值,那么客户机可以接收超出超时期指定值之内的响应消息。

Last-Modified/If-Modified-Since
Last-Modified/If-Modified-Since要配合Cache-Control使用。
Last-Modified:标示这个响应资源的最后修改时间。web服务器在响应请求时,告诉浏览器资源的最后修改时间。
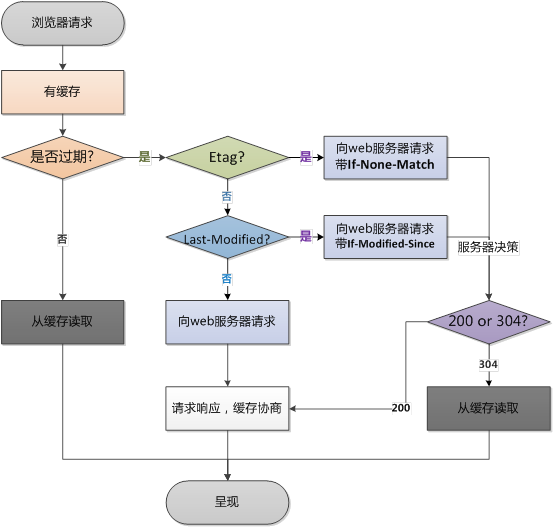
If-Modified-Since:当资源过期时(使用Cache-Control标识的max-age),发现资源具有Last-Modified声明,则再次向web服务器请求时带上头 If-Modified-Since,表示请求时间。web服务器收到请求后发现有头If-Modified-Since 则与被请求资源的最后修改时间进行比对。若最后修改时间较新,说明资源又被改动过,则响应整片资源内容(写在响应消息包体内),HTTP 200;若最后修改时间较旧,说明资源无新修改,则响应HTTP 304 (无需包体,节省浏览),告知浏览器继续使用所保存的cache。

Etag/If-None-Match
Etag/If-None-Match也要配合Cache-Control使用。
Etag:web服务器响应请求时,告诉浏览器当前资源在服务器的唯一标识(生成规则由服务器觉得)。Apache中,ETag的值,默认是对文件的索引节(INode),大小(Size)和最后修改时间(MTime)进行Hash后得到的。
If-None-Match:当资源过期时(使用Cache-Control标识的max-age),发现资源具有Etage声明,则再次向web服务器请求时带上头If-None-Match (Etag的值)。web服务器收到请求后发现有头If-None-Match 则与被请求资源的相应校验串进行比对,决定返回200或304。

HTTP1.1中Etag的出现主要是为了解决几个Last-Modified比较难解决的问题:

Last-Modified标注的最后修改只能精确到秒级,如果某些文件在1秒钟以内,被修改多次的话,它将不能准确标注文件的修改时间;
如果某些文件会被定期生成,当有时内容并没有任何变化,但Last-Modified却改变了,导致文件没法使用缓存;
有可能存在服务器没有准确获取文件修改时间,或者与代理服务器时间不一致等情形。

Etag是服务器自动生成或者由开发者生成的对应资源在服务器端的唯一标识符,能够更加准确的控制缓存。Last-Modified与ETag是可以一起使用的,服务器会优先验证ETag,一致的情况下,才会继续比对Last-Modified,最后才决定是否返回304。

浏览器缓存行为还有用户的行为有关,见下图:

用户操作 Expires/Cache-Control Last-Modified/Etag
地址栏回车 有效 有效
页面链接跳转 有效 有效
新开窗口 有效 有效
前进、后退 有效 有效
F5刷新 无效 有效
Ctrl+F5刷新 无效 无效

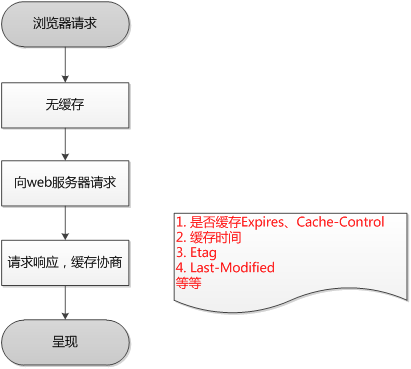
所以,当浏览器第一次请求时:

浏览器第一次请求

当浏览器第二次请求时:浏览器第二次请求


附:解决浏览器缓存导致不能显示最新页面问题的办法,详见http://www.eumz.com/2015-09/1231.html

DELL、HP、IBM X86服务器命名规则

各大服务器厂家对于自己的服务器命名都有一定的规则,通常会根据服务器的外观(如塔式、机架式、刀片等)、处理器(如Intel或者AMD等)、架构等信息来命名。本文主要介绍DELL、HP、IBM X86服务器的命名规则。

DELL服务器主要为X86架构服务器,包括机架式、塔式和刀片式服务器,对于DELL服务器第9代以前和第10代之后的服务器命名规则不同。
现以DELL R720来说明DELL X86服务器的命名规则,R代表机架式,T为塔式,M为刀片式,第一位7表示性能,数字越大越高端,3以下表示单路服务器,4到8表示双路服务器,9表示四路服务器,第二位2表示为DELL的第12代产品,第三位0表示采用Intel的CPU,如果是5则采用AMD的CPU。
第9代之前的命名规则,以DELL 2950服务器举例,第一位2表示性能,数字越大越高端,第二位表示服务器为第9代产品,第三位5表示机架式,如果是0则表示塔式,第四位0表示采用Intel的CPU,如果是5则表示采用AMD的CPU。

HP的X86服务器和DELL一样也包括塔式、机架式和刀片服务器,ML表示塔式,DL表示机架式,BL表示刀片。现以HP DL380 G7举例说明服务器命名规则,前两位表示性能,数字越大一般性能越强,第三位0表示采用Intel的CPU,如果是5则表示采用AMD的CPU,G7表示是HP的第7代产品。

对于IBM服务器,主要包括i系列、p系列、x系列、z系列。
i系列的服务器产品一直被大家命名为“小型机“,i系列服务器一般是中断产品,该系列产品用户主要是将众多的小型服务器合并到更少量的i系列产品中,i系列采用IBM POWER微处理器技术。
p系列也是基于POWER处理器的服务器,运行AIX(IBM版Unix)和Linux,p系列是IBM Unix服务器产品线的根基,有机架式和机柜式。
x系列全部基于X86架构处理器,也和DELL、HP一样包括塔式服务器、机架式服务器和刀片服务器。现以IBM X3850 X5服务器来说明命名规则,x3表明是x3架构下的服务器,第二位的8表明性能,数字越大表示性能越强,第三位的5表示机架式,如果是2或者3也表示机架式,如果第三位是0则表示塔式,如X3500服务器即为塔式服务器,第四位的0表示采用的是intel的CPU,5表示用的是AMD的CPU,最后的两位x5则是表示内存技术、内存扩展能力。
z系列为大型机,都为机柜式结构,该系列产品相当高端,是IBM的支柱产品。

SAS、NL-SAS、SATA硬盘的比较

When you buy a server or storage array these days, you often have the choice between three different kinds of hard drives: Serial Attached SCSI (SAS), Near Line SAS (NL-SAS) and Serial ATA (SATA). Yes, there are other kinds of drives, such as Fibre Channel, but I’m focusing this article on the SAS/SATA question. Further, even though solid-state disks (SSD) can have a SAS or SATA interface, I’m not focused here on SSDs. I’m focusing solely on the devices that spin really, really fast and on which most of the world’s data resides.

So, what is the real difference between SAS, NL-SAS and SATA disks? Well, to be cryptic, there are a lot of differences, but I think you’ll find some surprising similarities, too. With that, let’s dig in!

SAS
SAS disks have replaced older SCSI disks to become the standard in enterprise-grade storage. Of the three kinds of disks, they are the most reliable, maintain their performance under more difficult conditions, and perform much better than either NL-SAS or SATA disks.

In reliability, SAS disks are an order of magnitude safer than either NL-SAS or SATA disks. This metric is measured in bit error rate (BER), or how often bit errors may occur on the media. With SAS disks, the BER is generally 1 in 10^16 bits. Read differently, that means you may see one bit error out of every 10,000,000,000,000,000 (10 quadrillion) bits. By comparison, SATA disks have a BER of 1 in 10^15 (1,000,000,000,000,000 or 1 quadrillion). Although this does make it seem that SATA disks are pretty reliable, when it comes to absolute data protection, that factor of 10 can be a big deal.

SAS disks are also built to more exacting standards than other types of disks. SAS disks have a mean time between failure of 1.6 million hours compared to 1.2 million hours for SATA. Now, these are also big numbers – 1.2 million hours is about 136 years and 1.6 million hours is about 182 years. However, bear in mind that this is a mean. There will be outliers and that’s where SAS’s increased reliability makes it much more palatable.

SAS disks/controller pairs also have a multitude of additional commands that control the disks and that make SAS a more efficient choice than SATA. I’m not going to go into great detail about these commands, but will do so in a future article.

NL-SAS
NL-SAS is a relative newcomer to the storage game, but if you understand SATA and SAS, you already know everything you need to know about NL-SAS. You see, NL-SAS is basically a merging of a SATA disk with a SAS connector. From Wikipedia: “NL-SAS drives are enterprise SATA drives with a SAS interface, head, media, and rotational speed of traditional enterprise-class SATA drives with the fully capable SAS interface typical for classic SAS drives.”

There are two items of import in that sentence: “enterprise SATA drives” and “fully capable SAS interface”. In short, an NL-SAS disk is a bunch of spinning SATA platters with the native command set of SAS. While these disks will never perform as well as SAS thanks to their lower rotational rate, they do provide all of the enterprise features that come with SAS, including enterprise command queuing, concurrent data channels, and multiple host support.

Enterprise/tagged command queuing. Simultaneously coordinates multiple sets of storage instructions by reordering them at the storage controller level so that they’re delivered to the disk in an efficient way.
Concurrent data channels. SAS includes multiple full-duplex data channels, which provides for faster throughout of data.
Multiple host support. A single SAS disk can be controlled by multiple hosts without need of an expander.
However, on the reliability spectrum, don’t be fooled by the acronym “SAS” appearing in the product name. NL-SAS disks have the same reliability metrics as SATA disks – BER of 1 in 10^15 and MTBF of 1.2 million hours. So, if you’re thinking of buying NL-SAS disks because SAS disks have better reliability than SATA disks, rethink. If reliability is job #1, then NL-SAS is not your answer.

On the performance scale, NL-SAS won’t be much better than SATA, either. Given their SATA underpinning, NL-SAS disks rotate at speeds of 7200 RPM… the same as most SATA disks, although there are some SATA drives that operate at 10K RPM.

It seems like there’s not much benefit to the NL-SAS story. However, bear in mind that this is a SATA disk with a SAS interface and, with that interface comes a number of benefits, some of which I briefly mentioned earlier. These features allow manufacturers to significantly simplify their products.

SATA
Lowest on the spectrum is the SATA disk. Although it doesn’t perform as well as SAS and doesn’t have some of the enterprise benefits of NL-SAS, SATA disks remain a vital component in any organization’s storage system, particularly for common low-tier, mass storage needs.

When you’re buying SATA storage, your primary metric is more than likely to be cost per TB and that’s as it should be. SAS disks are designed for performance, which is why they’re available in 10K and 15K RPM speeds and provide significant IOPS per physical disk. With SAS, although space is important, the cost per IOPS is generally just as, if not more, important. This is why many organizations are willing to buy speedier SAS disks even though it means buying many more disks (than SATA or NL-SAS) to hit capacity needs.

Summary
At a high level, SAS and SATA are two sides of the storage coin and serve different needs — SAS for performance and SATA for capacity. Straddling the two is NL-SAS, which brings some SAS capability to SATA disks, but doesn’t bring the additional reliability found with SAS. NL-SAS helps manufacturers streamline production, and can help end users from a controller perspective, but they are not a replacement for SAS.

以上为英文版内容,大致总结如下:
SAS的优势在于性能,SATA的优势在于容量,NL-SAS介于两者之间。
闰秒导致linux服务器CPU利用率过高的解决办法

linux kernel 2.6.29之前版本存在bug,不仅仅是linux操作系统,一些服务器程序,如mysql和java都可能存在bug而导致服务器CPU利用率过高,有的能达到100%,原因可能为这些应用程序试图通过CPU硬件晶振的数据获得当前精确的时间。

解决这个问题的办法也很简单,只要关闭ntpd服务,并且修改系统时间,再开启ntpd服务即可,一般而言将服务器重启也可简单的解决问题。